Trabajo con varias sesiones de Claude Code abiertas a la vez, cada una en un proyecto distinto. Lanzo una tarea, me voy a otra ventana y al rato vuelvo a ver qué ha pasado. Tengo un aviso acústico (beep) que suena cuando el agente acabe la tarea.
Muchas sesiones a la vez de VS Code, y dentro varios terminales…
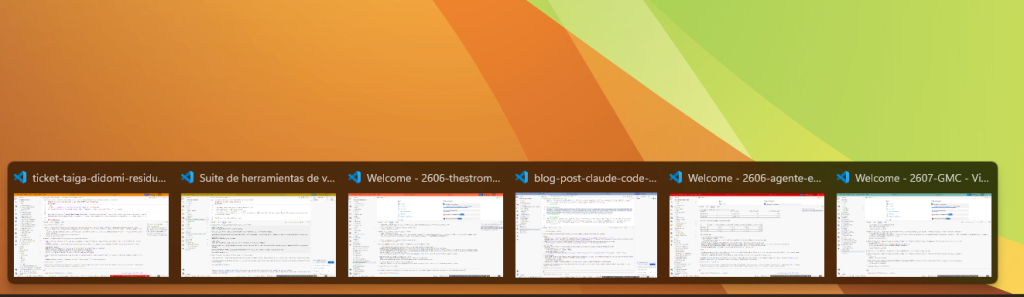
El problema es que muchas veces no hago caso al aviso, no lo oigo, vuelvo tarde o vuelvo a la sesión equivocada… Tengo que leerme medio informe para saber si aquello ha acabado bien. Lo que llaman ahora «deuda cognitiva» jeje…
Así que este pasado fin de semana me he montado algo bastante sencillo: cuando Claude termina de responder, me lee en voz alta la conclusión. Solo la conclusión, no toda la respuesta.
Primero, que cada respuesta acabe con un resumen
La pieza que hace posible todo lo demás no tiene nada de técnica. En mis instrucciones globales de Claude Code (el CLAUDE.md que se carga en todas las conversaciones) tengo una regla de estilo: los mensajes con algo de chicha tienen que cerrar con una fórmula corta tipo «en resumen», «en definitiva» y/o «queda de tu parte», que separe lo que ha hecho el agente de lo que me toca hacer a mí.
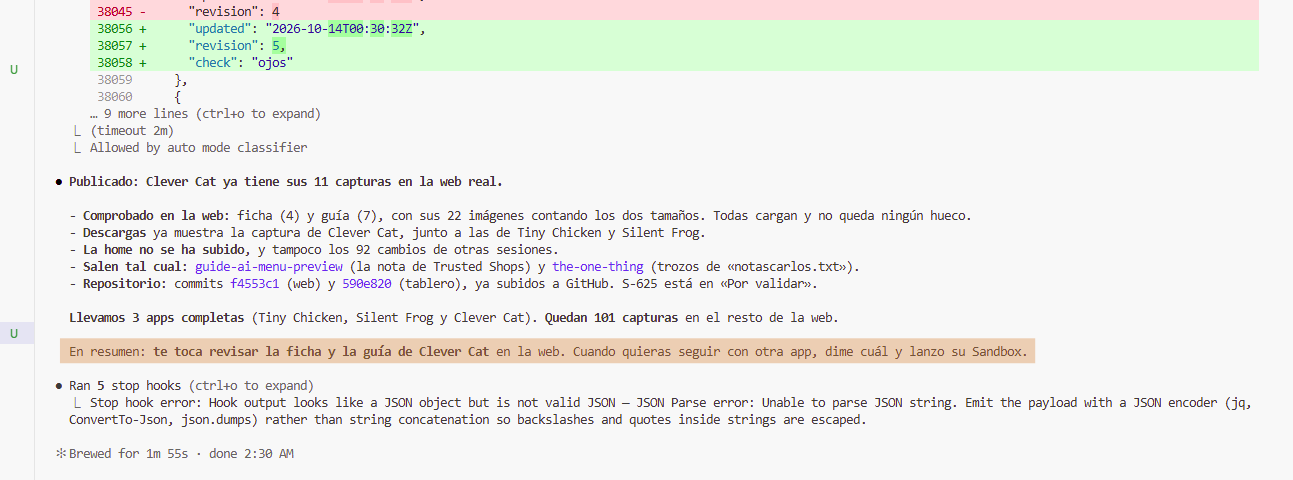
Esa regla la puse antes de pensar en la voz, porque me venía bien para leer en diagonal. Pero resulta que deja el terreno perfecto para lo otro. Si el modelo ya me escribe una frase final que condensa el resultado, no necesito pedirle a otra IA que resuma nada: el resumen ya está hecho y además lo ha escrito quien conoce todo el contexto de la tarea. Solo hay que encontrarlo y leerlo.
Un hook que se dispara al terminar cada respuesta
Claude Code tiene hooks, que son comandos que se ejecutan en momentos concretos de la sesión. Uno de ellos es Stop, que salta justo cuando el agente termina de contestar. Ahí he enganchado un script de Python:
"Stop": [
  {
    "hooks": [
      {
        "type": "command",
        "command": "python C:/Users/JFERRAZ/.claude/hooks/leer_resumen.py",
        "timeout": 15
      }
    ]
  }
]
El script recibe la última respuesta del asistente y busca el último bloque que empieza por una de esas frases de cierre. Se queda con ese párrafo, le quita el formato Markdown (negritas, enlaces, comillas de código, viñetas) y lo corta a 600 caracteres como mucho. Si por lo que sea la respuesta no trae cierre, tira del primer párrafo de prosa, que suele llevar la conclusión, y lo deja en 300 caracteres.
Un detalle que cambié enseguida: ya no lee las palabras «en resumen». Oírlas veinte veces al día cansa, así que el script las quita y, de vez en cuando (un 15 % de las veces), mete delante una muletilla al azar tipo «Mira,» o «A ver,…», sin repetir la anterior.
Parece una tontería, pero se nota mucho menos robótico y natural.
La voz la pone ElevenLabs
Con el texto limpio, el script llama a la API de text-to-speech (TTS) de ElevenLabs con el modelo eleven_v4 y una voz en español, Eleanor, a velocidad 1,15 porque la normal se me hacía lenta.
Devuelve un mp3, se reproduce con el reproductor multimedia que trae Windows y se borra al terminar. La clave de la API vive en un .env aparte, fuera de git.
La parte que más me preocupaba era no frenar a Claude. Generar el audio y reproducirlo lleva unos segundos, así que el hook lanza la lectura en un proceso aparte y vuelve al instante. Claude por tanto no espera a que acabe de hablar para ponerse con otra cosa si yo se la mando.
Y si llega una respuesta nueva mientras todavía suena la anterior, la anterior se corta y empieza la nueva… o también, si me pilla en una llamada pulso Esc y se calla.
Detalle que me encanta, como trabajo con varias sesiones, añadí otra cosa: el script mira qué ventana tengo en primer plano.
- Si es la del mismo proyecto, lee el resumen tal cual.
- Si estoy en otra, empieza con «En referencia al proyecto…» y el nombre de la carpeta, así sé de qué sesión viene la voz sin tener que ir a mirar.
¡Hasta hay un pequeño diccionario de pronunciación para los nombres de proyecto que la voz destrozaba! 🙂
Encenderlo y apagarlo hablando normal
No siempre quiero que me hable, así que tiene interruptor. Hay un comando /voz que lo alterna, y también entiende frases sueltas como «activa la voz», «deja de leer» o «apaga la lectura».
Eso lo resuelve otro hook, el que se ejecuta cuando envío un mensaje: si la frase coincide con una de esas órdenes, cambia el interruptor y bloquea el mensaje para que no llegue al modelo. No gasta un turno ni tokens en algo que es un simple on/off.
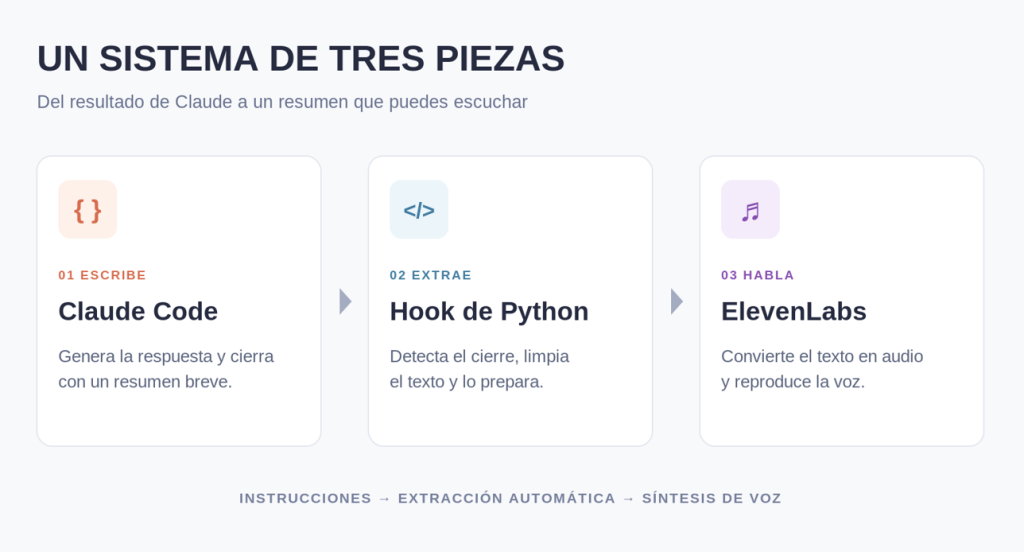
Un sistema de «tres piezas»
Lo bueno de todo este montaje es que cada pieza hace una sola cosa.
- El modelo escribe el resumen porque se lo pido en las instrucciones,
- el hook lo encuentra con una expresión regular y
- ElevenLabs le pone voz.
Si un día cambio de proveedor de voz (y está twitter ahora mismo muy hot con proyectos de TTS), solo toco una función.
Y si el modelo se olvida del cierre, que a veces pasa, el resultado es leer el primer párrafo, que tampoco está mal.
Tiene sus limitaciones, claro. Depende de que el modelo respete la regla del cierre, la extracción por texto es frágil si el formato de la respuesta se sale de lo habitual y cada lectura cuesta unos céntimos de API.
Pero el cambio en el día a día ha sido mayor de lo que esperaba: ahora me entero de cómo ha acabado una tarea sin volver a la ventana y además de modo inmediato, y solo vuelvo cuando hay algo que me toca hacer a mí.
Eso sí, ¡es un roba-focos terrible! 😂